Photo

I am a first-year PhD student in Computer Science at the University of Illinois Urbana-Champaign, advised by Prof. Minjia Zhang. Prior to UIUC, I was fortunate to be advised by Prof. Yingyan (Celine) Lin at the EIC Lab as a Research Assistant in the School of Computer Science, Georgia Tech.

My research focuses on efficient and interpretable foundation models. Specifically: (1) Leveraging sparsity, compression, and combining system optimizations to improve the efficiency of inference and post-training processes for foundation models. (2) Designing new decoding and modeling paradigms that make efficient LLMs broadly accessible.

Outside of research, I like to stay healthy by working out regularly, and I'm really into playing 🎾 tennis. It keeps me both physically and mentally sharp.
   /      /   zhengw10 [at] illinois (dot) edu


Research Interest


News


Selected Publications (see full publication list here; * indicates equal contribution)


Efficient LLM Inference & Compression
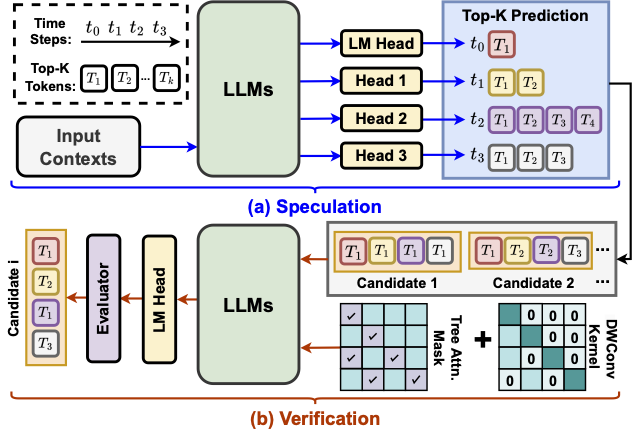
Zheng Wang, Davis Wertheimer, Yu Chin Fabian Lim, Mudhakar Srivatsa, Raghu K. Ganti, Minjia Zhang, Naigang Wang
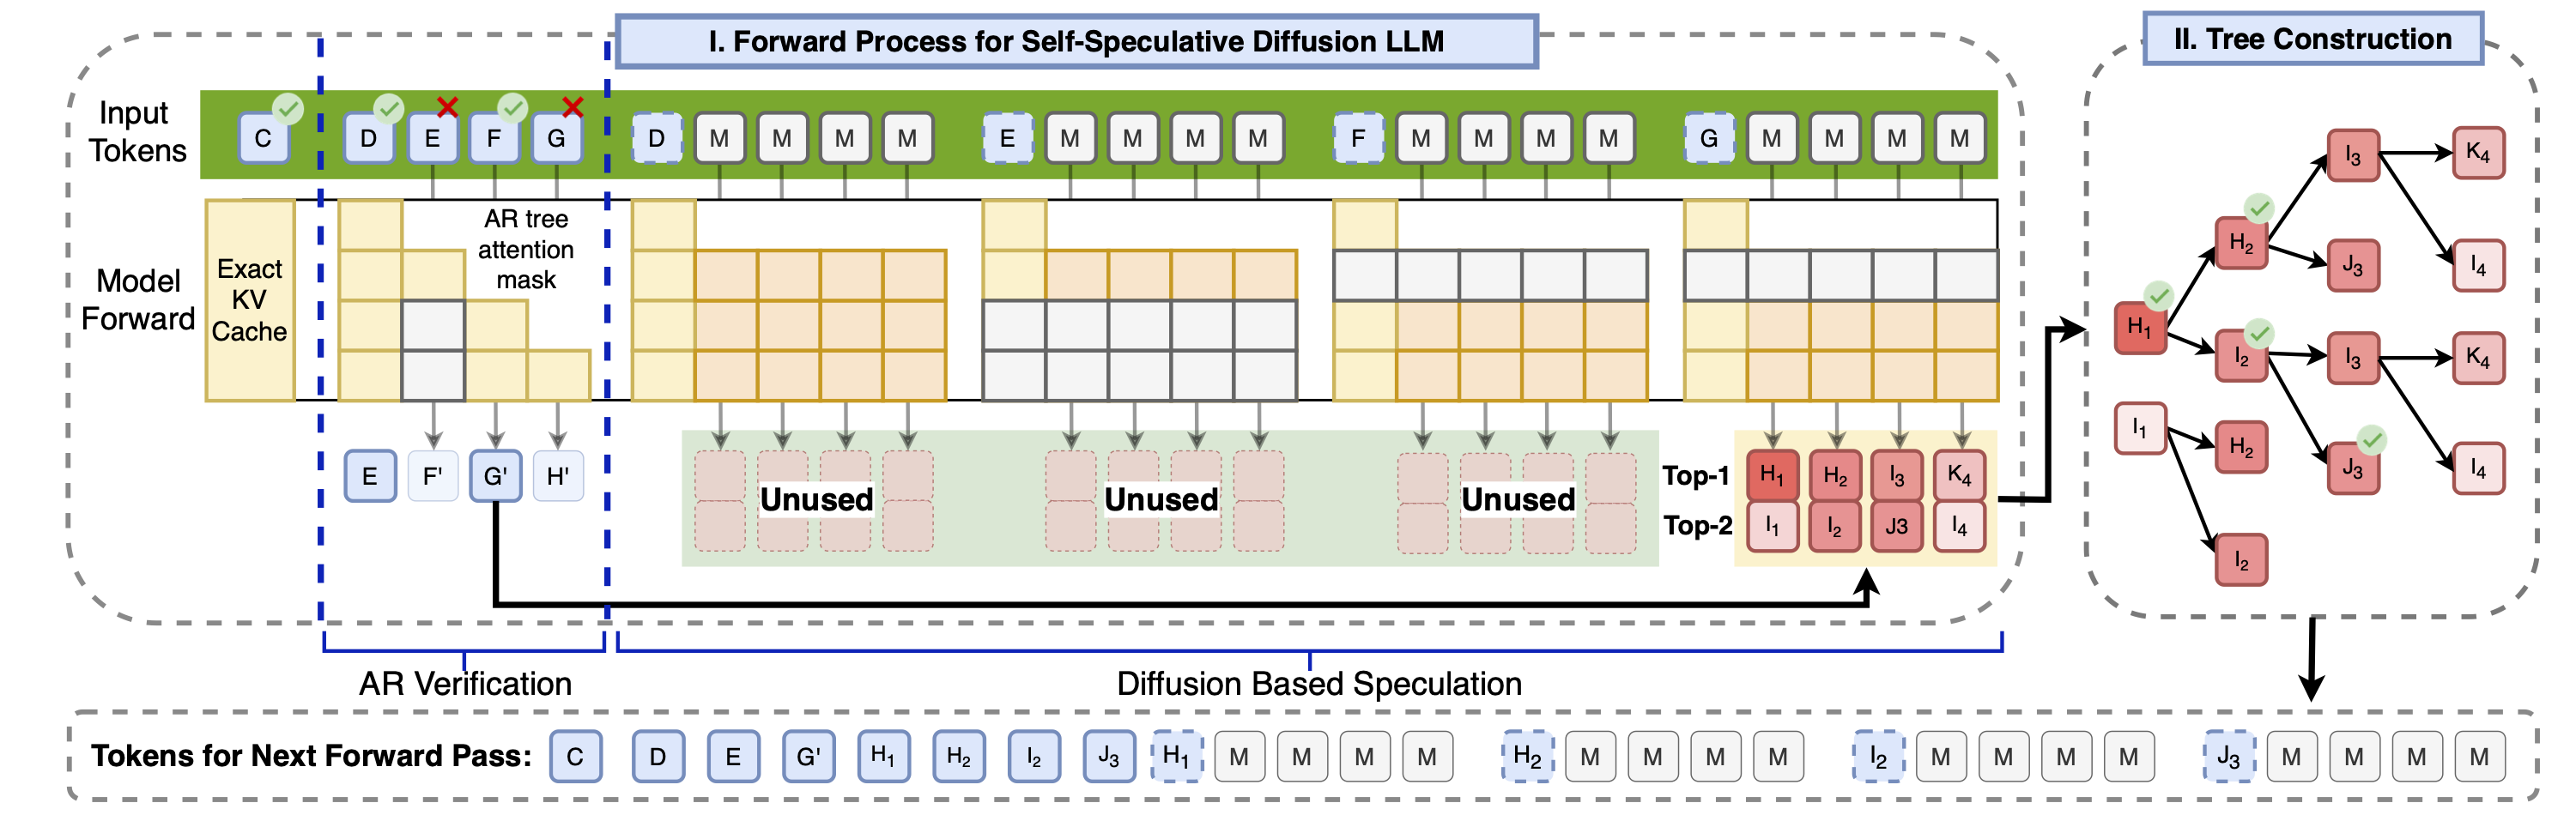
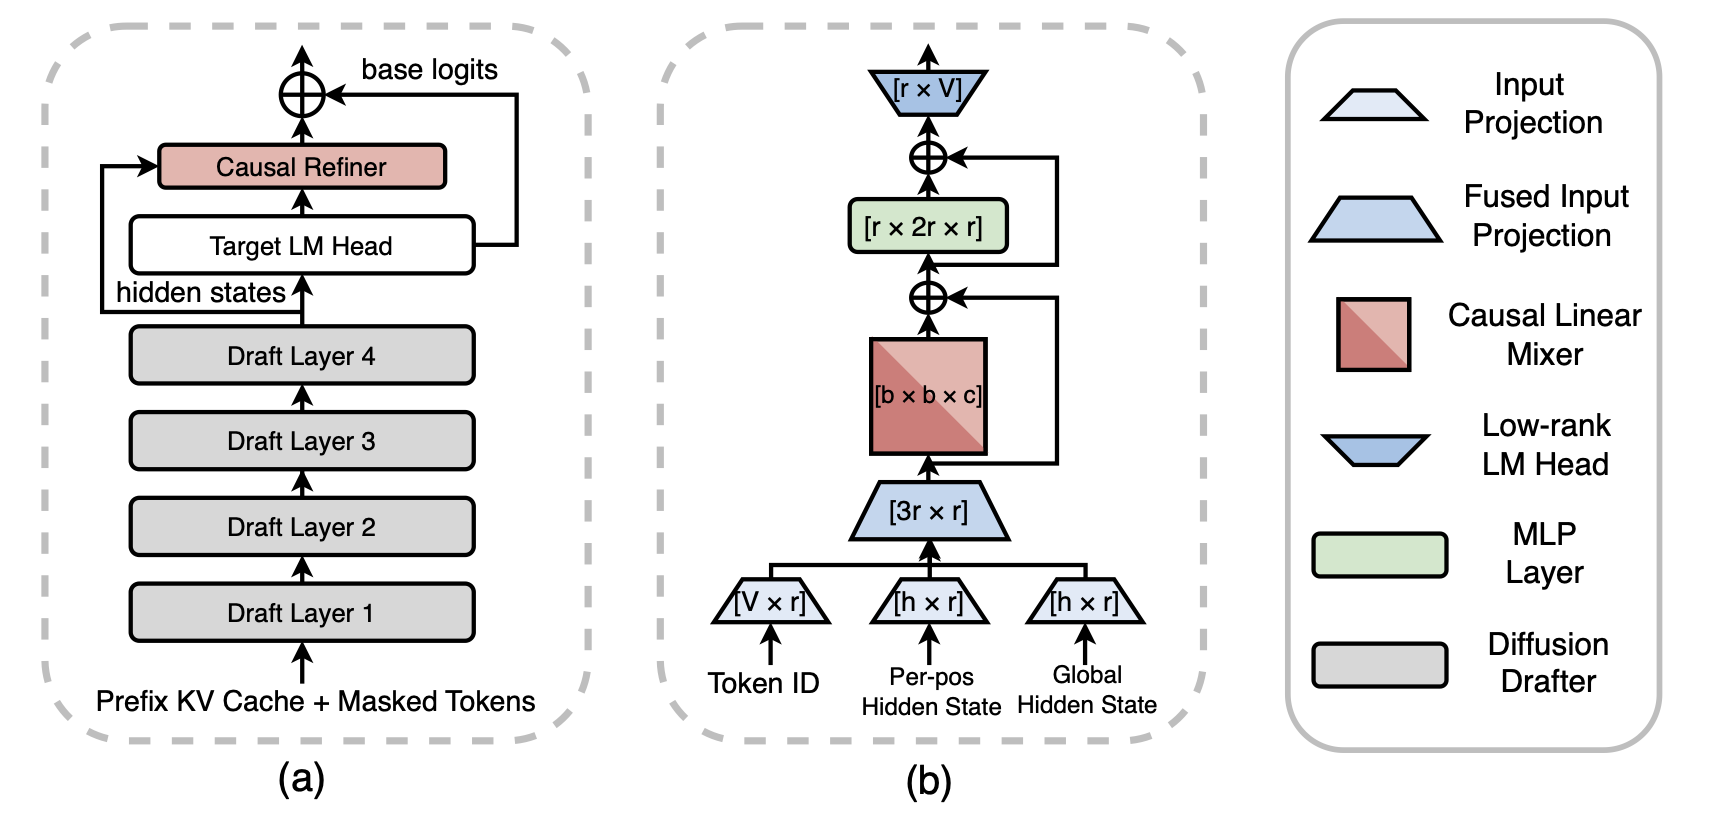
xPress: Parallel Refinement for Diffusion Drafters in Speculative Decoding
arXiv preprint, 2026 [Paper] [Code] [Blog] [vLLM] [Speculators]
vLLMIntegrated in vLLM!
SpeculatorsIntegrated in Speculators!

Zheng Wang*, Zhifan Ye*, Qi Cheng, Yonggan Fu, Ziyan Wang, Feng Zhu, Haozhe Zhao, Jan Kautz, Pavlo Molchanov, Humphrey Shi, Minjia Zhang
PRESTO: Prefix-Aligned Tree Drafting for Diffusion Speculative Decoding
COLM 2026 Workshop on Efficient Reasoning [Paper]
🏆 Oral & Best Paper Candidate

Haochen Shen, Davis Wertheimer, Zheng Wang, Garrett Goon, Derrick Liu, Naigang Wang, Mudhakar Srivatsa, Raghu K. Ganti, Minjia Zhang
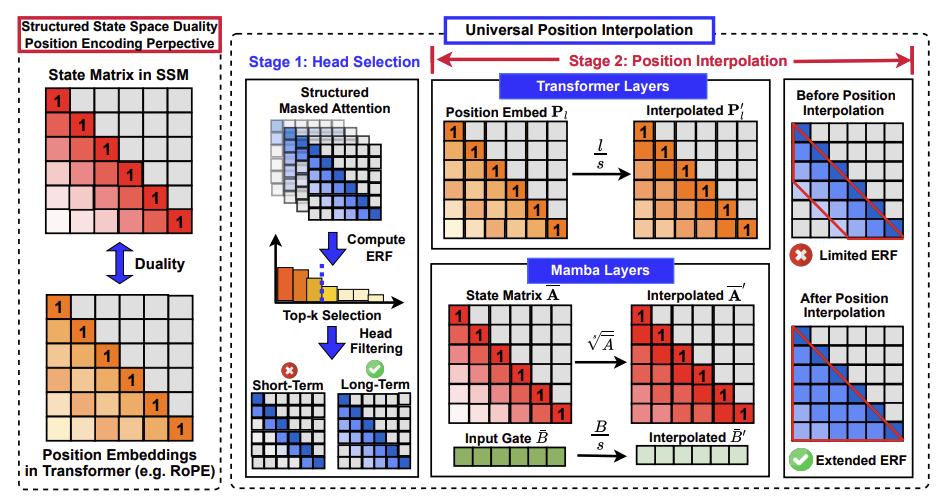
From Collapse to Control: Understanding and Extending Context Length in Emerging Hybrid Models via Universal Position Interpolation
ICLR 2026 [Paper]

Yushu Zhao*, Zheng Wang*, Minjia Zhang
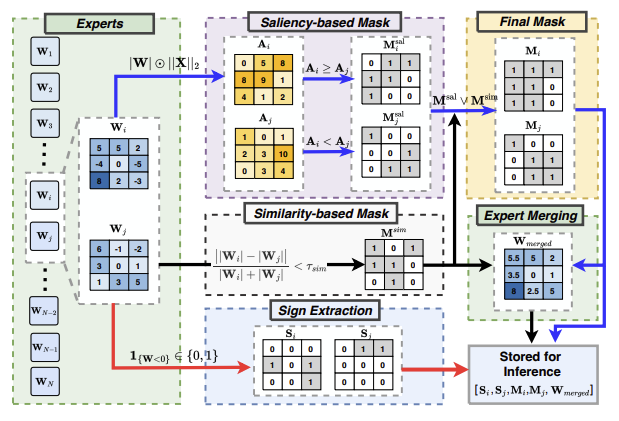
PuzzleMoE: Efficient Compression of Large Mixture-of-Experts Models via Sparse Expert Merging and Bit-packed Inference
ICML 2026 [Paper]

Zhifan Ye, Zheng Wang, Kejing Xia, Jihoon Hong, Leshu Li, Lexington A. Whalen, Cheng Wan, Haoran You, Celine Lin, Souvik Kundu
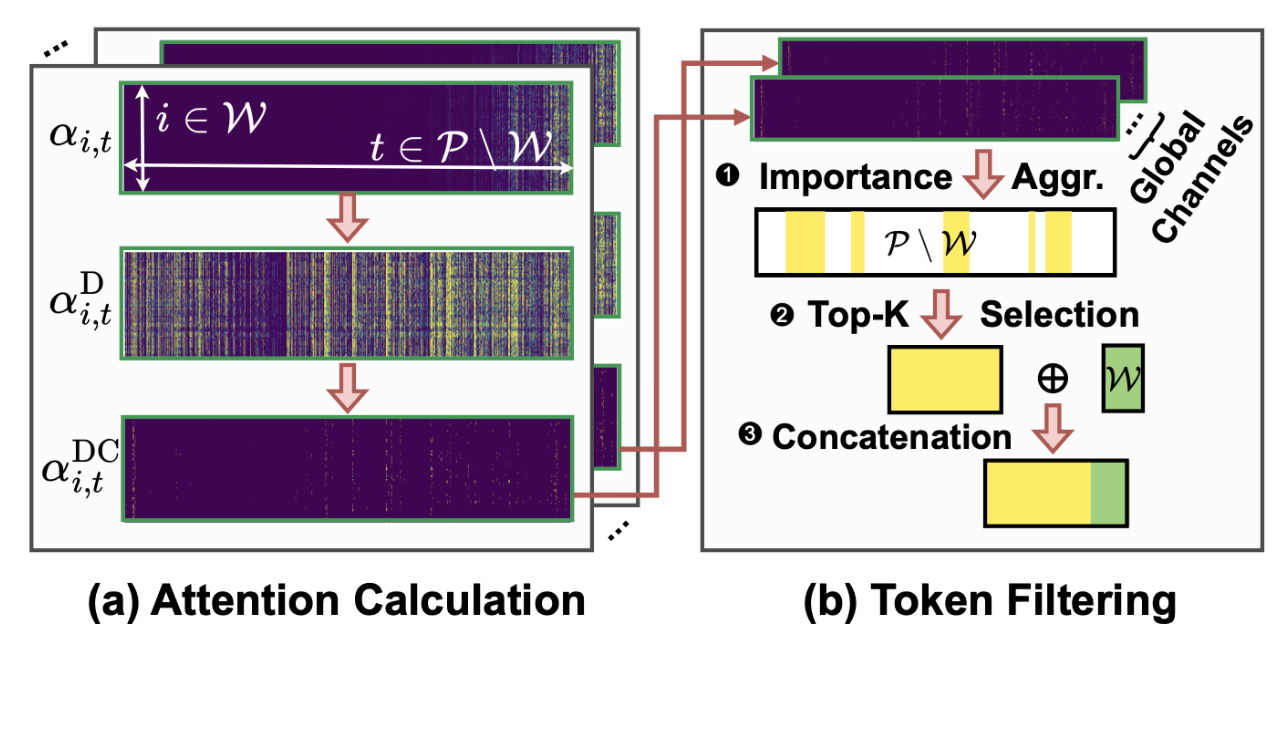
LAMB: A Training-Free Method to Enhance the Long-Context Understanding of SSMs via Attention-Guided Token Filtering
ACL 2025 [Paper]

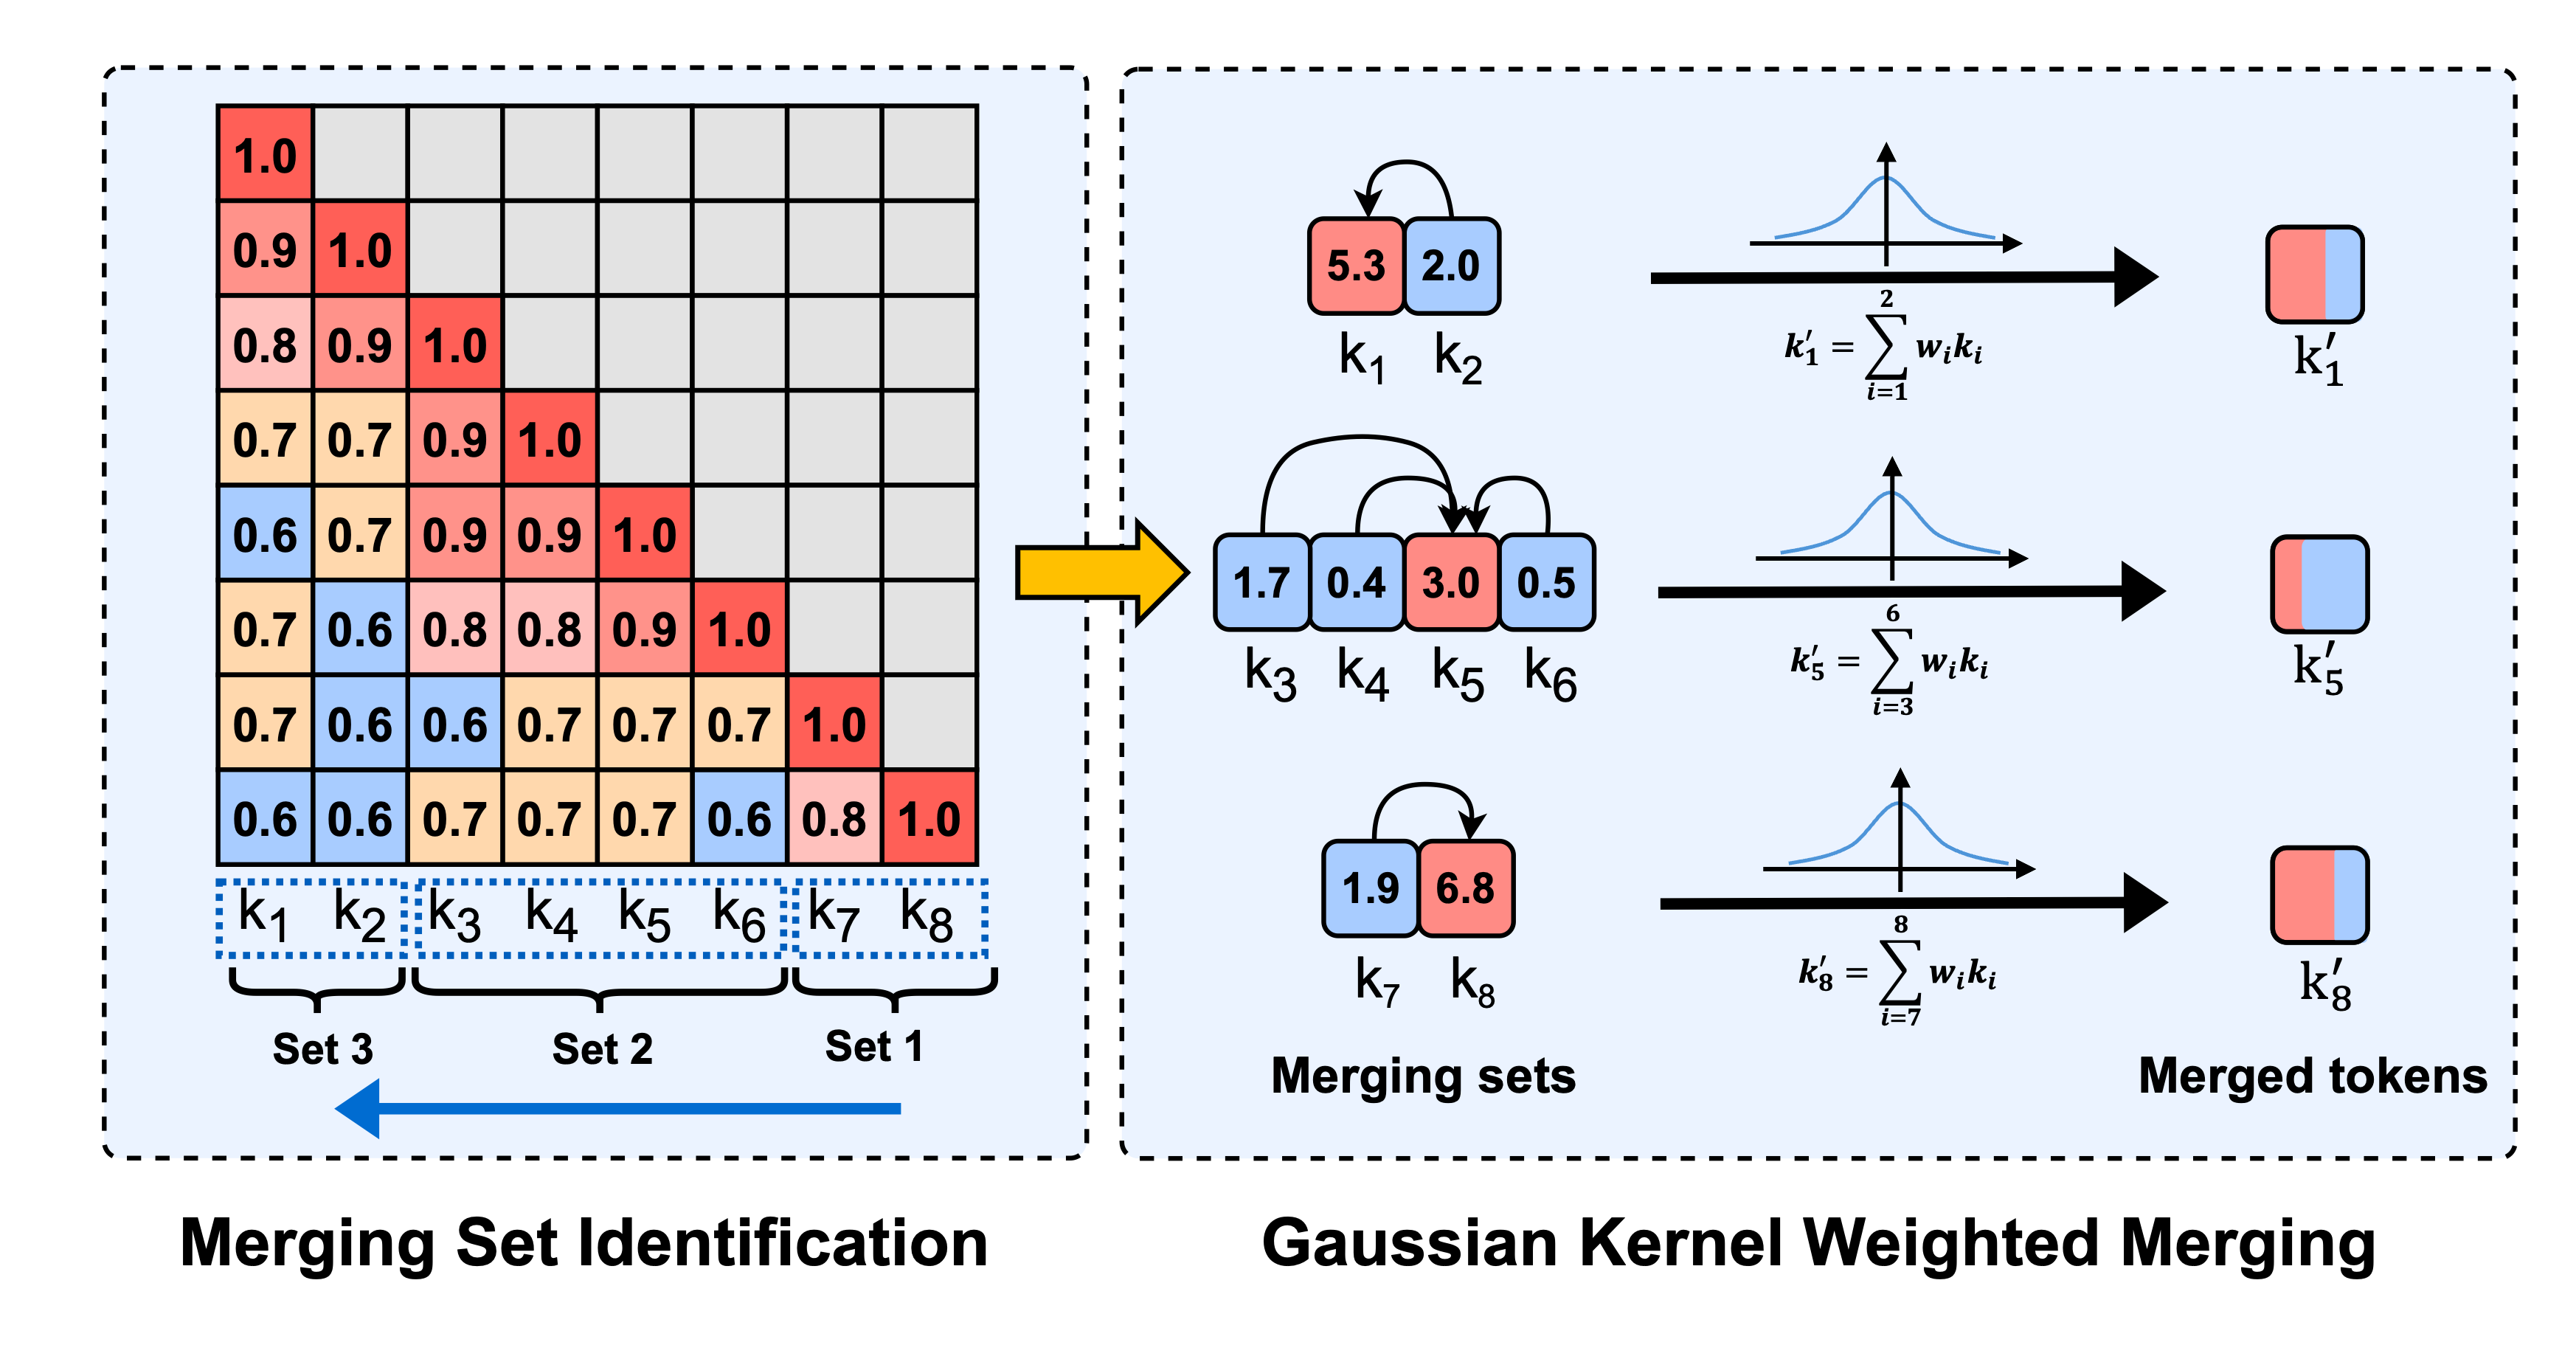
Zheng Wang, Boxiao Jin, Zhongzhi Yu, Minjia Zhang
Model Tells You Where to Merge: Adaptive KV Cache Merging for LLMs on Long-Context Tasks
arXiv preprint, 2024 [Paper]

Haoran You, Yichao Fu, Zheng Wang, Amir Yazdanbakhsh, Yingyan (Celine) Lin
When Linear Attention Meets Autoregressive Decoding: Towards More Effective and Efficient Linearized Large Language Models
ICML 2024 [Paper] [Code]

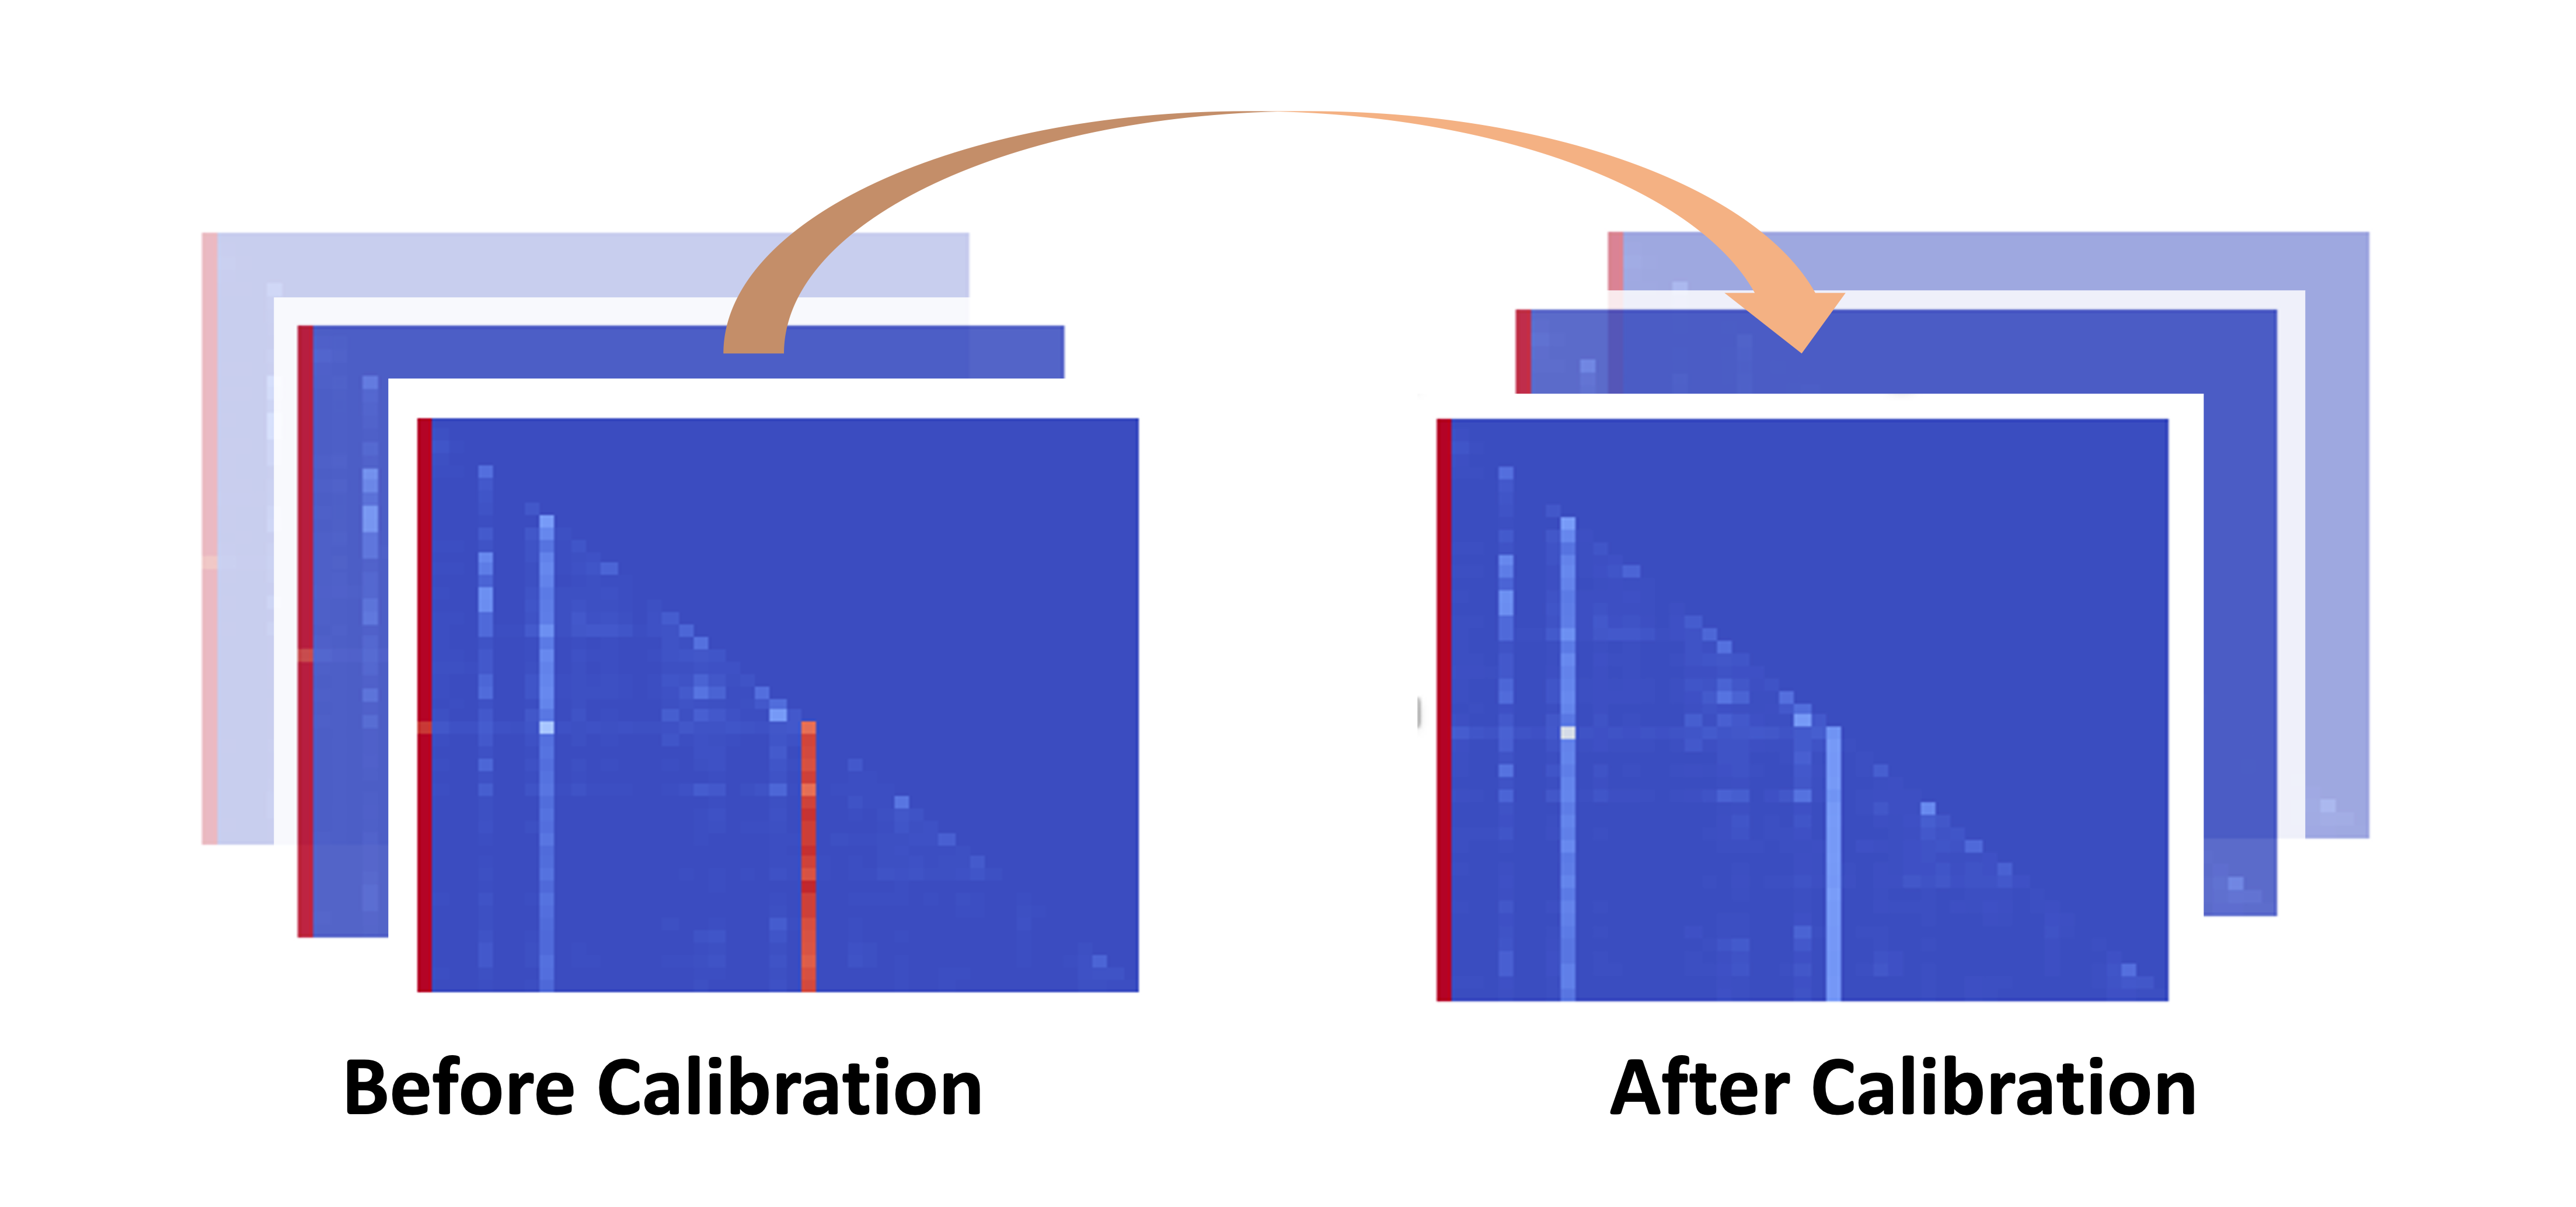
Zhongzhi Yu*, Zheng Wang*, Yonggan Fu, Huihong Shi, Khalid Shaikh, Yingyan (Celine) Lin
Unveiling and Harnessing Hidden Attention Sinks: Enhancing Large Language Models without Training through Attention Calibration
ICML 2024 [Paper] [Code]

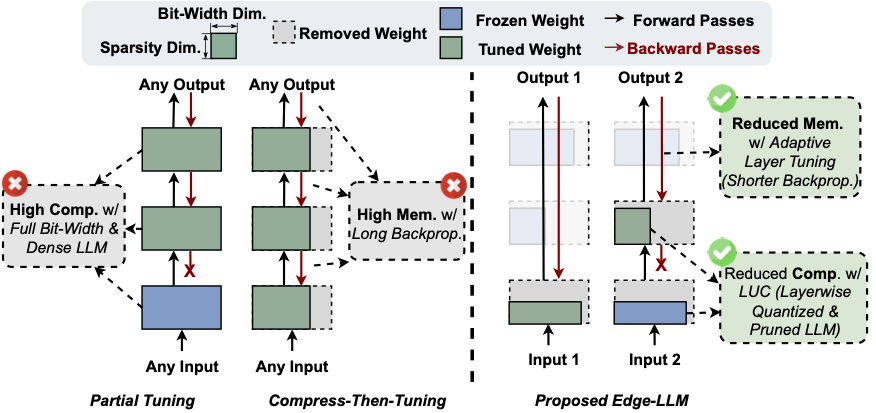
Zhongzhi Yu, Zheng Wang, Yuhan Li, Haoran You, Ruijie Gao, Xiaoya Zhou, Sreenidhi Reedy Bommu, Yang Katie Zhao, Yingyan (Celine) Lin
EDGE-LLM: Enabling Efficient Large Language Model Adaptation on Edge Devices via Layerwise Unified Compression and Adaptive Layer Tuning & Voting
DAC 2024 [Paper] [Code]

Efficient LLM Reasoning & Test-Time Compute
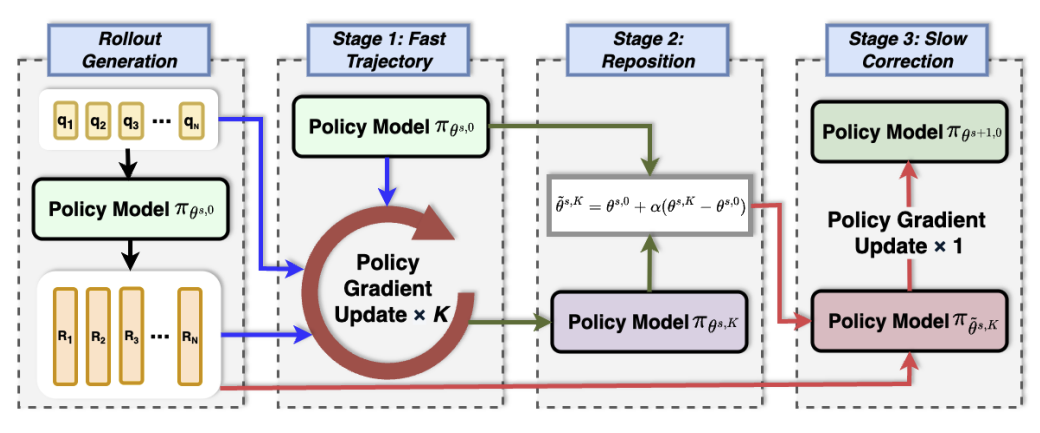
Ziyan Wang*, Zheng Wang* Xingwei Qu, Qi Cheng, Jie Fu, Shengpu Tang, Minjia Zhang, Xiaoming Huo
Slow-Fast Policy Optimization: Reposition-Before-Update for LLM Reasoning
ICLR 2026 [Paper] [Website] [Code]

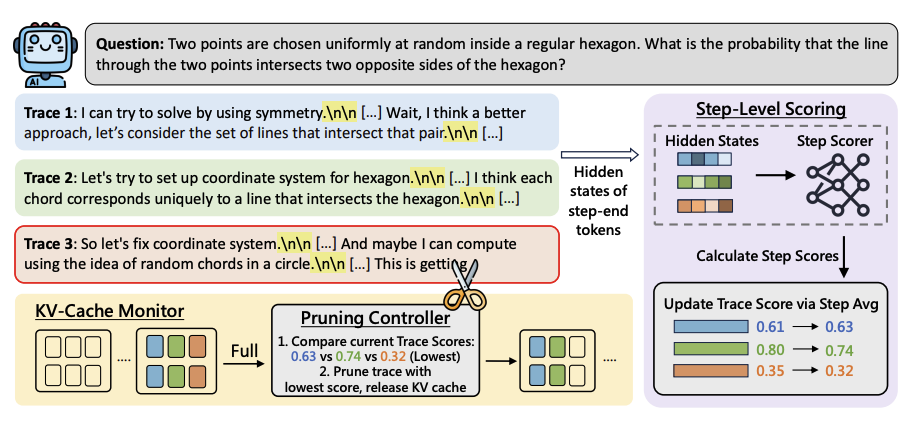
Zhixiang Liang, Beichen Huang, Zheng Wang, Minjia Zhang
Hidden States as Early Signals: Step-level Trace Evaluation and Pruning for Efficient Test-Time Scaling
ACL Findings, 2026 [Paper] [Code]

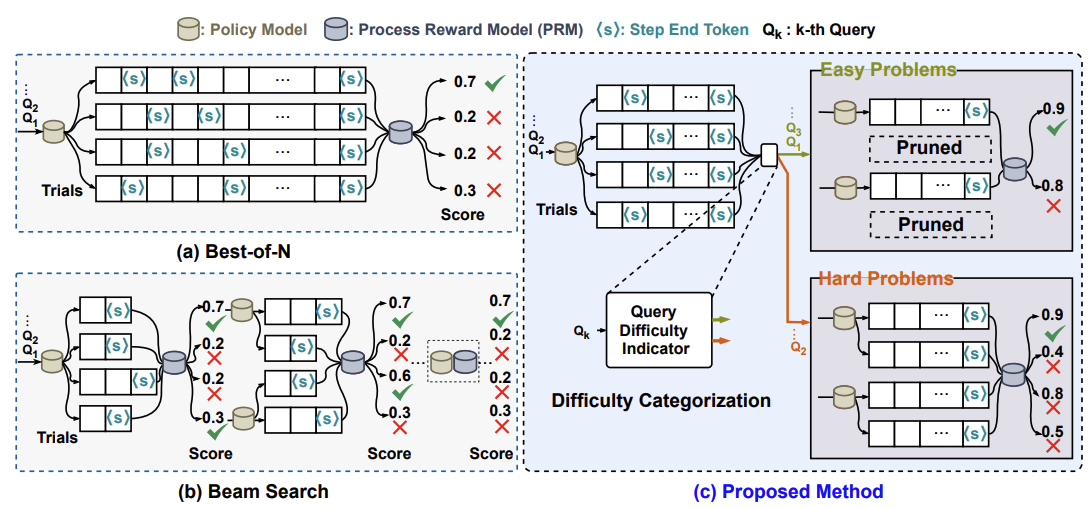
Hyewon Suh, Chaojian Li, Cheng-Jhih Shih, Zheng Wang, Kejing Xia, Yonggan Fu, Yingyan (Celine) Lin
Think Hard Only When Needed: A Hybrid Best-of-N and Beam Search for Efficient Test-Time Compute
EACL 2026 [Paper]

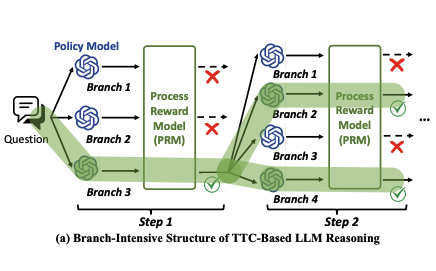
Sixu Li, Yuzhou Chen, Chaojian Li, Yonggan Fu, Zheng Wang, Zhongzhi Yu, Haoran You, Zhifan Ye, Wei Zhou, Yongan Zhang, Yingyan (Celine) Lin
ORCHES: Orchestrated Test-Time-Compute-based LLM Reasoning on Collaborative GPU–PIM Heterogeneous System
MICRO 2025 [Paper]


Teaching


Services


Selected Awards


Invited Talks


© Zheng Wang 2026. Layout adapted from Yonggan Fu's homepage.